Approximate Membership Query:Bloom Filter と Quotient Filter
Category: DS & Algo
Bloom Filter
Bloom Filter は確率的(probabilistic)な性質を持つハッシュテーブルの一種です。最大の特徴は、一般的なハッシュテーブルと比べて空間・時間の両面で優位性があることです。
Bloom Filter は、値が か の配列で表現できます。ある要素があるかどうかを query すると、Bloom Filter が返せる答えは「ない」か「あるかもしれない」の 2 つだけです。つまり、誤判定は False Positive しか起こり得ません。
この特性のおかげで、「一次フィルタリング」が必要な場面にとても向いています:
- 「一度しかクリックされない」不人気なページを除外する(アクセス数が閾値または 2 回目以上に達したときだけキャッシュに入れて、帯域を節約する
- 昔の Chrome は Bloom Filter を使って悪意のある URL をフィルタリングしていた(悪意がある可能性のある URL は別のサーバーに送って処理する)
- データベース内で存在しない要素を検索する際、無駄な時間を大幅に減らす
- レコメンドシステムで、ユーザーがすでに見たコンテンツを除外する
Bloom Filter を実装するには、まず配列のサイズとして数値 を選び、配列を で初期化します。次に 個のハッシュ関数を選び、入力を配列の 個の位置にマッピングします。要素を保存するときは、その要素をハッシュ関数に通し、対応する 個の位置の値を にします。要素を query するときは、 個のハッシュ関数が指す位置がすべて の場合にのみ True を返し、そうでなければ False を返します。こうすることで、False Positive しか起こり得ない query を実現しています。
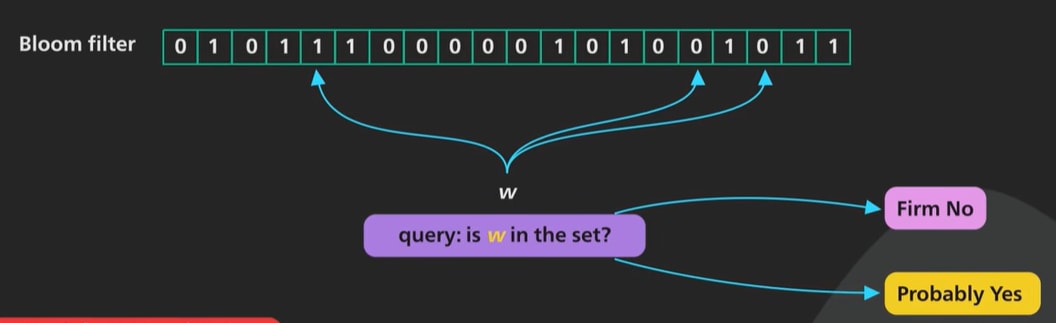
注意点
- と は 1. 保存を見込む要素数 と 2. 許容できる誤判定率 から決めることができます
-
保存する要素が多いほど、また要求される誤判定率が低いほど、配列の長さは大きくなる
-
要求される誤判定率が低いほど、ハッシュ関数の数は多くなる
-
個のハッシュ関数がマッピングする値は均等に分布し、かつ異なる位置間に相関がないべきで、しかも が大きくなるほど 個のハッシュ関数を設計するのは難しいタスクになる
-
一般的なデータ構造と比べて、Bloom Filter は要素そのものを保存する必要がない(ハッシュ値だけを見ているため)ので、保存と検索の両方で有利()であり、機密性の要件を満たせる場合もある
-
Bloom Filter にすでに保存された要素は削除できない。ハッシュ先の位置をすべて に戻すことはできるが、それは他の要素にも影響してしまい、False Negative が起きないという利点を失ってしまう
-
誤判定率はデータが増えるほど上がっていくが、 が十分大きければ無視できるレベルになる
Quotient Filter
Quotient Filter は、Bloom Filter が要素を削除できないという弱点を補っており、しかも複数の Quotient Filter をマージすることができます。
Quotient Filter の操作は Bloom Filter とだいたい同じで、要素の挿入と query です。ハッシュ関数は 1 つだけで、要素がそのハッシュ関数を通ると、結果は 2 つの部分に分かれます:
- 前方のビット(MSB)が Quotient で、要素が配列内のどの位置にあるかを表す
- 残りのビット(LSB)が Remainder(Fingerprint) で、配列の中に保存される
例えば長さ の配列が必要な場合、ハッシュ結果の先頭 3 ビット()が Quotient になり、残りのビット(Remainder)が配列に保存されます。
Remainder のほかに、配列の各スロットにはさらに 3 ビットのメタデータが使われます。それぞれ:
is_occupied:このスロットが、ある要素の「本来の家(Canonical Location)」であることを表す(注意:必ずしもこのスロットに実際に入っている要素の家とは限らない)is_continuation: の場合、このスロットの要素がある Run の先頭であることを表すis_shifted:このスロットの要素が、すでに Canonical Location にはなく、後方にずらされていることを表す

ある要素の位置がその quotient と一致するとき、その位置をその要素の Canonical Location と呼びます。複数の要素が同じ Quotient を持つとき、それらは同じ Run に属していると言います。
例えば 3 つの要素 、、 を順番に挿入し、それぞれの quotient が 、、 だとすると:
- はスロット に挿入され、メタデータは
- はスロット がすでに埋まっていて、しかもメタデータが ——つまり同じ Run の先頭であることを見て、linear probe でスロット に挿入され、メタデータは 。 と同じ Run に属する
- はスロット がすでに埋まっていて、しかもメタデータが ——つまりこのスロットにいるのはこの Run でもなく、自分の Run の先頭でもない要素であることを見る。そこでまずスロット の
is_occupiedを にして、スロット を自分の Run としてマークし、 になる。その後 linear probe でスロット に挿入し、is_shiftedを に設定、メタデータは
そうすると:
- を query するとき、スロット のメタデータが で remainder も一致するので、そこが Canonical Location だとすぐに分かる
- を query するとき、スロット の remainder が一致しないので後方を探し続け、
is_continuationが になる前に必ず を見つけられる - を query するとき、まず
is_occupiedが であることが分かるが、remainder が一致せずis_continuationが なので、このスロットは別の Run に属するものだと判断できる。ここからはさらに別のルールを使って掘り下げて探す必要があり、少し複雑で、しかもネット上でもきちんと説明している人がいないようなので、興味があれば元の論文を参照してください。ただ、Quotient、Remainder、メタデータ、この 3 つさえ押さえておけば、要素の削除もできる効率的な AMQ を実現できるということだけ覚えておけば大丈夫です
削除の操作もやや複雑で、要素を見つける、remainder を削除する、詰め直す、メタデータを更新する、といった手順が必要ですが、安全に削除できることは保証されています。
最後に、一度も挿入されたことのない要素 を想像してください。その remainder がちょうどうまい具合にどこかで見つかってしまう——これが Quotient Filter における false positive で、remainder の衝突(collision)から生まれるものです。
まとめ
データ量が非常に大きく、一次フィルタリング用のデータ構造が必要なとき、Bloom Filter は今でも第一候補です。成熟していてシンプル、実装しやすいからです。一方 Quotient Filter は linear probing を利用しており、ハードウェアキャッシュに優しく、連続読み取りの速度は Bloom Filter を上回ることが多く、動的な削除が必要な場面に向いています。
Reference
- Bloom Filters | Algorithms You Should Know #2 | Real-world Examples
- (counting) quotient filter(この人の例はなかなか良いが、typo が多くて理解の妨げになる。とはいえ quotient filter の大まかな動作イメージはつかめる)
- Quotient Filter Explained | Probabilistic Data Structure To Check Membership