Approximate Membership Query:Bloom Filter 與 Quotient Filter
Category: DS & Algo
Bloom Filter
Bloom Filter 是一種 hash table,帶有機率性(probabilistic)。他最大的特色是比起一般的 hash table,具有空間和時間上的優勢
Bloom Filter 可以用一個值為 或 的陣列表示。query 有沒有某項元素時,Bloom Filter 只會有兩個回答:「沒有」或「可能有吧」。換句話說,誤判的情況只會有 False Positive
這種特性使他很適合用在一些需要「初步過濾」的場景
- 過濾掉『只被點一次』的冷門網頁(只有當存取次數達到閥值或第二次以上時,才放進 cache 節省頻寬
- 以前的 Chrome 用 Bloom Filter 過濾惡意網址(可能是惡意網址的再送去別台 server 處理)
- 資料庫中查找不存在的元素,避免大量時間浪費
- 推薦系統中過濾使用者已查看過的內容
實作 Bloom Filter 時需要挑一個數字 當作陣列的大小,將陣列初始化為 。再挑 個 hash function,將輸入映射到陣列的 個位置。儲存元素時將元素過 hash function,將陣列中 個位置的值設為 。Query 元素時,只有當 個 hash function 對應到的位置都是 時才回傳 True,否則回傳 False,以此來實現只可能是 False Positive 的查詢
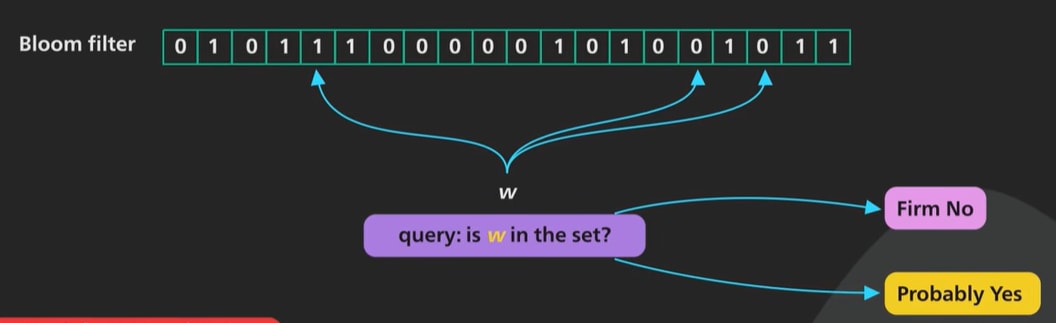
注意事項
- 與 可以由1. 預期儲存的元素數量 及 2. 可接受的誤判率 決定
-
儲存的元素越多、要求的誤判率越低,陣列長度越大
-
要求的誤判率越低,hash function 越多
-
個 hash function 對到的值應該要平均分布,並且不同位置間沒有相關性,而且設計 個 hash function 當 變大時會是不容易的任務
-
比起一般的資料結構,Bloom Filter 不需要儲存元素本身(因為他關注的是 hash 值),在儲存和查找上都有優勢(),且可以滿足某些保密要求
-
Bloom Filter 中已儲存的元素無法被刪除。雖然可以把 Hash 到的位置都改為 ,但會影響到其他元素,失去沒有 False Negative 這個優勢
-
誤判率會隨資料增加而上升,但對於較大的 可以忽略不計
Quotient Filter
Quotient Filter 彌補了 Bloom Filter 不能刪除元素的弱點,並且多個 Quotient Filter 是可以並在一起的
Quotient Filter 的操作跟 Bloom Filter 差不多,也是插入與 query 元素。Hash function 只會有一個,當元素經過 hash function,結果會分成兩部分
- 前面的 bit(msb) 為 Quotient,用來表示元素在陣列中的位置
- 剩下的 bit(lsb) 為 Remainder(Fingerprint),用來存在陣列裡面
如果我們需要長度為 的陣列,那 hash 結果的前三個() bit 會當成 Quotient,剩下的 bit(Remainder)則會存在陣列裡
除了 Remainder,陣列裡每格還會再用三個 bit 當作 metadata,他們分別為
is_occupied:代表這格是某個元素的「原本的家(Canonical Location)」(注意不一定是存在這格的元素的家)is_continuation: 代表這格放的元素是某個 Run 的頭is_shifted:代表這格裡的元素,已經不在它的 Canonical Location,而是被往後移位了

當一個元素的位置與他的 quotient 相符,稱那個位置為 Canonical Location。當有一個以上的元素有相同的 Quotient 時,稱他們屬於同一個 Run。
假設依序插入三個元素 、、,他們的 quotient 分別為 、、,那麼
- 會被插在第 格,metadata 為
- 由於看到第 格被占了,且 metadata 是個 ,代表他是同一個 Run 的頭。於是 linear probe 插在第 格,metadata 為 ,與 屬於同個 Run
- 由於看到第 格被占了,且 metadata 是個 ,代表 有一個不是這個 Run,也不是他自己 Run 的頭的元素在這格。於是先將第 格的
is_occupied設成 ,把第 格標成自己的 Run,變成 ,再 linear probe 插在第 格,把is_shifted設為 ,metadata 為
那麼
- Query 時看第 格的 metadata 是 ,且 remainder 也對的上,很容易得知那就是他的 Canonical Location
- Query 時由於第 格的 remainder 對不上所以往後找,一定能在
is_continuation為 前找到 - Query 時首先會看到
is_occupied為 ,但 remainder 不對且is_continuation為 ,可以判斷這格是別的 Run 的元素,此時會再用另一套規則深入搜尋,有點複雜,而且網路上好像也沒人能講清楚,有興趣的請參考原論文。但只要記住透過 Quotient、Remainder、metadata 這三個東西,就能實現一個有效率且能刪除元素的 AMQ
刪除的動作也較為複雜,包含找到元素、刪掉 remainder、補位、修改 metadata,但可以保證是能安全刪除的
最後,想像一個沒有被加入的元素 ,他的 remainder 在一個剛剛好的地方被找到了,這就是 Quotient Filter 的 false positive,來自 remainder 的 collision
總結
當資料量極大,需要一個初步過濾的資料結構時,Bloom Filter 仍然是首選,因為它成熟且簡單、易於實作。Quotient Filter 則是運用了 linear probing,對硬體 cache 友好,連續讀取的速度往往優於 Bloom Filter,且適用於須動態刪除的場景
Reference
- Bloom Filters | Algorithms You Should Know #2 | Real-world Examples
- (counting) quotient filter(這人的例子不錯但 typo 不少很干擾理解,但能提供一個 quotient filter 大概運作的感覺)
- Quotient Filter Explained | Probabilistic Data Structure To Check Membership